Spotkanie Absolwentów Wydziału Kultury Japonii PJATK z okazji 20-lecia

Każdego dnia, często nawet tego nie zauważając, zostawiamy po sobie ślady w postaci danych. Zamawiamy jedzenie w aplikacji, sprawdzamy trasę w nawigacji, oglądamy serial w serwisie VOD albo lajkujemy post znajomego. Każda z tych aktywności rejestruje drobny fragment naszej cyfrowej codzienności, który osobno wydaje się błahy i nieistotny dla nikogo, ale w masowej skali tworzy ogromny, wartościowy zasób informacji dla firm, administracji czy twórców usług.
Prawdziwym wyzwaniem nie jest jednak samo gromadzenie tych danych, lecz przekształcenie ich w zrozumiałe wzorce, wnioski i decyzje biznesowe – właśnie w tym miejscu na scenę wchodzi data science.
Najprościej rzecz ujmując, data science to dziedzina, która łączy metody naukowe, statystykę, programowanie i wiedzę o konkretnej branży po to, by z danych wyciągać jak najbardziej użyteczne wnioski. Nazwa bywa tłumaczona jako “nauka o danych”, ale lepiej oddaje jej istotę określenie “analityka danych w wydaniu badawczym”. Chodzi tu bowiem o systematyczne, oparte na dowodach podejście do rzeczywistości opisanej liczbami.
Data science można wyobrazić sobie jako pracę na styku trzech różnych światów: liczb, technologii i biznesu. Z jednej strony mamy fundament w postaci matematyki i statystyki, z drugiej umiejętność programistycznego zarządzania oraz porządkowania danych, a z trzeciej rozumienie konkretnego obszaru działalności firmy, na przykład finansów, marketingu czy przemysłu. Dopiero osoba, która potrafi swobodnie poruszać się w tych trzech światach, jest w stanie przełożyć surowe dane na prognozy i rekomendacje, które realnie wpływają na decyzje i wyniki organizacji.
Warto tu też pamiętać, iż data science jest ściśle powiązana z big data, bo to właśnie te ogromne, szybko przyrastające zbiory danych stanowią “paliwo” dla analiz i modeli tworzonych przez data scientistów. Big data dostarcza surowego materiału, a data science odpowiada za wyciągnięcie z niego wzorców, prognoz i rekomendacji, które można realnie wykorzystać w biznesie.
Skoro wiemy już, czym jest sama dziedzina, przyjrzyjmy się specjalistom, którzy się nią zajmują. Data scientist, nazywany też naukowcem albo badaczem danych, to specjalista, który zbiera, porządkuje, analizuje i interpretuje dane, by na podstawie ukrytych w nich wzorców budować prognozy i scenariusze wspierające decyzje biznesowe.
Dobrym porównaniem będzie tu zawód lekarza diagnostyka, który na podstawie wielu wyników badań i objawów stawia rozpoznanie. Badacz danych “bada” kondycję firmy i otoczenia rynkowego, łączy rozproszone sygnały i przekłada liczby na konkretne rekomendacje, pomagające przewidywać trendy i rozwiązywać problemy.
Codzienność data scientistów to w dużej mierze praca “na zapleczu” danych i układa się w powtarzalny rytm, choć żaden projekt nie jest identyczny. Zwykle zaczyna się od “oswojenia” danych, czyli poznania ich struktury, pochodzenia i kondycji, bo bez tego trudno zaplanować cokolwiek sensownego. Później przychodzi najbardziej żmudna część, czyli porządkowanie zdobytego materiału, gdyż rzeczywiste dane rzadko bywają kompletne i spójne, więc usuwanie błędów, uzupełnianie braków i ujednolicanie formatów potrafi pochłonąć lwią część projektu.
Dopiero na tak przygotowanym fundamencie badacz buduje modele matematyczne, sięgając po algorytmy i metody statystyczne, które mają przewidzieć konkretne zjawisko czy zachowanie.
Ostatni, równie ważny etap, to przełożenie wyników na zrozumiały przekaz. Surowe liczby same w sobie nikogo nie przekonają, dlatego data scientist ubiera je w różne formy wizualizacji danych, od prostych liczb i tabel, przez wykresy i infografiki, aż po interaktywne dashboardy tak, aby także osoby spoza świata danych pojęły, co z tej analizy wynika. To właśnie ta umiejętność tłumaczenia złożoności na prosty język decyduje często o tym, czy projekt analityczny faktycznie wpłynie na późniejsze decyzje firmy.
Warto podkreślić, że to nie jest praca wyłącznie “przy kodzie”. Jak pisaliśmy wcześniej, data scientist łączy umiejętności programistyczne, matematyczne i biznesowe, ale też analizuje przeszłość, by trafniej przewidywać przyszłe trendy i zachowania. To rola pośrednika między surowymi danymi a strategicznymi decyzjami zarządu, blisko spokrewniona z analitykiem danych i inżynierem danych, którzy razem tworzą zespół pracujący na big data.
Teoria nabiera sensu dopiero wtedy, gdy zobaczymy, jak data science w biznesie przekłada się na konkretne pieniądze i decyzje. Firmy sięgają po nią choćby po to, by trafniej przewidywać popyt i nie zamrażać kapitału w niepotrzebnych zapasach. Równie często wykorzystują ją do lepszego rozumienia klientów, systemy rekomendacji podpowiadają kolejne zakupy, a modele wychwytujące sygnały rezygnacji, pozwalają zatrzymać odbiorców, zanim ci odejdą do konkurencji. Analityka usprawnia też bieżące operacje, bo stałe monitorowanie procesów ułatwia szybką reakcję na odstępstwa, a w obszarze ryzyka potrafi wyłapać zagrożenia czy próby oszustw, zanim te zdążą wyrządzić szkodę.
Szczególnie wyraźnie widać to w marketingu, gdzie analiza danych pomaga dzielić klientów na spójne segmenty i przewidywać ich przyszłe zachowania na podstawie tego, jak postępowali do tej pory. Korzyści sięgają jednak dużo dalej, dobrze poprowadzona analityka porządkuje procesy decyzyjne, podnosi skuteczność sprzedaży i wspiera zarządzanie zespołami. Trudno więc się dziwić, że na specjalistów od danych polują dziś nie tylko firmy technologiczne, lecz także banki, sieci handlowe, agencje marketingowe i placówki ochrony zdrowia.
Wbrew obiegowej opinii start w analityce danych nie oznacza konieczności opanowania dziesiątek technologii naraz. Najpewniejszym punktem wyjścia są dwa języki. Pierwszy to SQL, który wciąż najczęściej przewija się w wymaganiach z ogłoszeń o pracę, drugi zaś to Python, uznawany za podstawowe narzędzie do pracy z danymi i tworzenia modeli. Nie jest to przypadek – Python od lat utrzymuje się na szczycie rankingów popularności języków i wyjątkowo dobrze sprawdza się w analizie danych, big data oraz uczeniu maszynowym.
Wokół tych podstaw narasta z czasem szerszy warsztat. W codziennej analizie i budowie modeli pomagają biblioteki pokroju NumPy, pandas, Matplotlib czy Scikit-learn, a gdy w grę wchodzi uczenie głębokie, dołączają do nich frameworki TensorFlow i PyTorch. Wyniki trzeba jeszcze podać w czytelnej formie, stąd powinna pojawić się też znajomość narzędzi wizualizacyjnych takich jak Power BI czy Tableau, a przy naprawdę dużych zbiorach – rozwiązań ze świata big data, czyli Apache Hadoop i Spark, oraz platform chmurowych Microsoftu, Google i Amazona.
Sam zestaw narzędzi to jednak nie wszystko. Równie istotne, a często trudniejsze do wyuczenia, są kompetencje miękkie, a więc analityczny sposób myślenia, umiejętność zadawania trafnych pytań, naturalna ciekawość i zdolność jasnego tłumaczenia wyników innym. Bez nich nawet najbogatszy arsenał technologiczny nie wystarczy, by zamienić dane w realne decyzje.
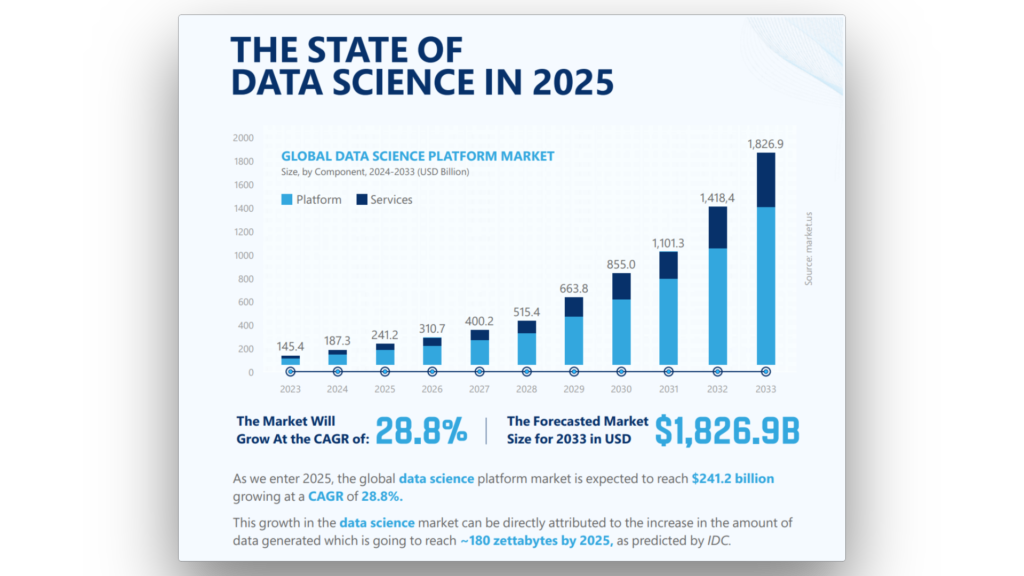
Liczby mówią same za siebie. Globalny wolumen danych rośnie wykładniczo i w zeszłym roku miał sięgnąć rzędu 180 zettabajtów, co bezpośrednio napędza popyt na specjalistów potrafiących nad tymi danymi zapanować (źródło: USDSI).
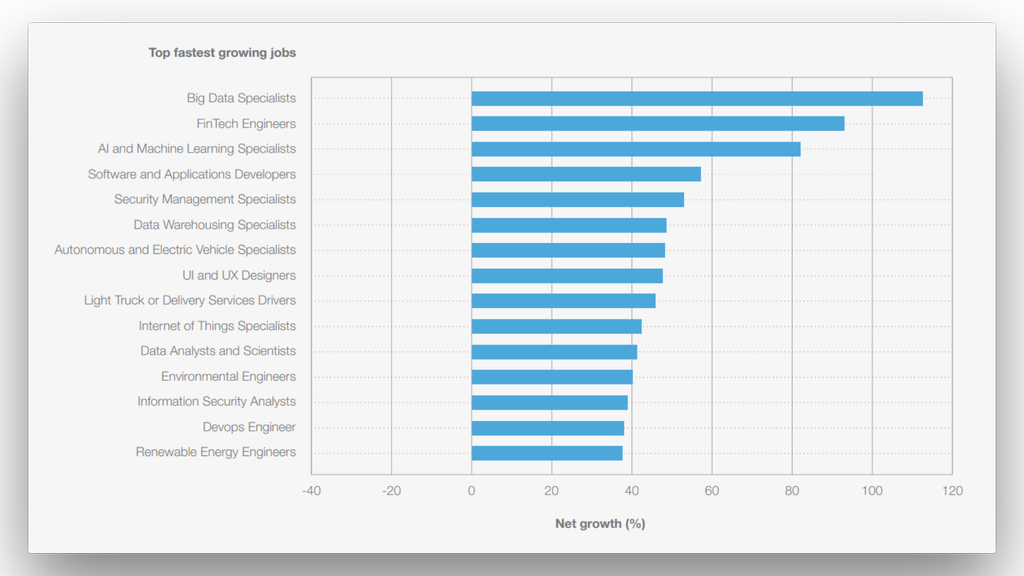
Co więcej, World Economic Forum wprost wskazuje, że role związane z data science i analityką należą do najszybciej rosnących na rynku pracy.
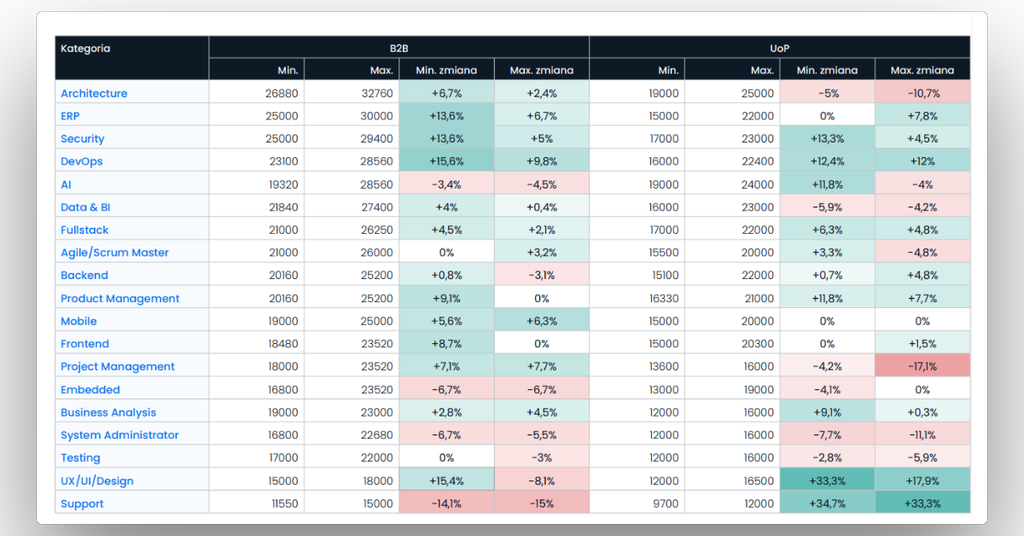
Polski rynek potwierdza ten trend także po stronie wynagrodzeń. Z najnowszego raportu No Fluff Jobs “Rynek pracy IT 2025/2026” wynika, że w obszarze Data & BI mediana widełek na kontraktach B2B mieści się mniej więcej w przedziale od 21,8 tys. do 27,4 tys. zł netto miesięcznie, a na umowie o pracę – od 16 tys. do 23 tys. zł brutto.
Co istotne, obie granice widełek dla tej kategorii w porównaniu z poprzednim rokiem wzrosły, wprawdzie nieznacznie, ale to pokazuje, że praca z danymi pozostaje stabilnie i wysoko wyceniana – specjalizacje z obszaru Data & BI od lat plasują się w czołówce najlepiej opłacanych ról w polskim IT.
Skoro perspektywy są tak obiecujące, pojawia się naturalne pytanie: od czego zacząć? Solidną podstawą jest wykształcenie informatyczne, które daje znajomość programowania, matematyki i statystyki, czyli fundamentów, bez których trudno zrozumieć zaawansowane techniki analizy i sztucznej inteligencji.
Takie przygotowanie zapewnia kierunek Informatyka w PJATK. Studia inżynierskie kładą nacisk na praktykę, projekty, laboratoria i staże realizowane we współpracy z topowymi firmami technologicznymi, a w programie pojawiają się obszary kluczowe dla analityki danych, a więc statystyka, sztuczna inteligencja, systemy inteligentne i data science. Ponadto na Wydziale Informatyki działa osobna katedra Systemów Inteligentnych i Data Science, a studenci poznają najnowsze narzędzia AI i uczą się rozwiązywać realne problemy informatyczne.
Dla osób, które mają już dyplom i chcą wyspecjalizować się w pracy z danymi, dobrym kierunkiem są studia podyplomowe Big Data – inżynieria dużych zbiorów danych. Program prowadzi przez cały proces pracy z danymi, od ich przetwarzania, przez analizę, aż po praktyczne wykorzystanie wyników i obejmuje narzędzia Data Science, programowanie w Pythonie i R, biblioteki NumPy, SciPy, Matplotlib i Scikit-learn, ekosystem Apache (Hadoop, Spark) oraz powiązania big data z uczeniem maszynowym. Studia są skierowane zarówno do informatyków i programistów, jak i do specjalistów z innych branż, którzy chcą wykorzystywać dane w swojej pracy zawodowej.
Data science to dziś jedna z najważniejszych dziedzin cyfrowej gospodarki, łączy bowiem statystykę, programowanie i wiedzę biznesową, by z surowych danych tworzyć trafne prognozy i lepsze decyzje. Data scientist nie tylko buduje modele, lecz także zadaje właściwe pytania i opowiada “historię danych” w sposób zrozumiały dla biznesu.
W parze z rosnącym wolumenem danych i atrakcyjnymi zarobkami sprawia to, że analityka danych pozostanie jednym z najbardziej perspektywicznych zawodów najbliższych lat. A ponieważ wszystko zaczyna się od solidnych fundamentów, czyli matematyki, programowania i myślenia analitycznego, dobrze dobrane studia informatyczne lub podyplomowe są najpewniejszą drogą, by w tym świecie zaistnieć.