Na czym polega praca AI Developera i jak nim zostać?

Do tej pory sztuczna inteligencja kojarzyła się nam przede wszystkim z ogromnymi centrami danych. To właśnie tam trenowano modele, a później obsługiwano kolejne zapytania użytkowników. Telefon, kamera czy robot pełniły często rolę terminala, a więc zbierały dane, wysyłały je przez sieć i czekały na wynik obliczeń wykonanych setki kilometrów dalej.
Ten model nie znika, ale przestaje być jedynym możliwym. Coraz więcej zadań AI trafia bezpośrednio do urządzeń, od smartfonów i sprzętu domowego po drony oraz linie produkcyjne. Za zmianą stoi Edge AI, czyli wykonywanie obliczeń związanych ze sztuczną inteligencją blisko miejsca powstawania danych. Kluczową rolę odgrywają w tym wyspecjalizowane układy NPU, które przejmują inferencję wymagającą dużej wydajności przy możliwie małym zużyciu energii.
Stawką jest coś więcej niż wygodniejszy asystent w telefonie. Wyścig o Edge AI dotyczy tego, kto będzie kontrolował warstwę obliczeniową przyszłych urządzeń, narzędzia do uruchamiania modeli i cały łańcuch dostaw półprzewodników. Lokalna autonomia maszyny okazuje się więc ściśle związana z globalną zależnością od krzemu.
Centra danych pozostaną podstawą trenowania największych modeli i obsługi najbardziej wymagających zadań. Ich dalsza rozbudowa ma jednak cenę. Według danych przywoływanych przez Komisję Europejską światowe centra danych zużyły około 415 TWh energii elektrycznej w 2024 roku, a do 2030 roku zapotrzebowanie może wzrosnąć do około 945 TWh. Jednym z głównych motorów wzrostu mają być obciążenia związane z AI.
Przeniesienie części inferencji na urządzenia nie sprawi oczywiście, że koszt energetyczny zniknie. Zmieni się jednak miejsce jego powstawania i sposób gospodarowania nim. Zamiast transmitować każdy fragment obrazu, dźwięku czy telemetrii do serwera, urządzenie może najpierw rozpoznać lokalnie, które dane są ważne. Do sieci trafi wtedy wynik analizy albo niewielki wycinek materiału, a nie ciągły strumień surowych informacji.
Takie podejście ma znaczenie tam, gdzie liczy się czas reakcji. Dron omijający przeszkodę nie może uzależniać decyzji od jakości zasięgu. Robot przemysłowy nie powinien czekać na odpowiedź serwera, gdy kamera wykryje człowieka w strefie pracy. W tych zastosowaniach opóźnienie sieciowe nie jest drobną niedogodnością, lecz elementem wpływającym na bezpieczeństwo.
Lokalne przetwarzanie zmienia też model ochrony danych. Nagranie głosu, obraz wnętrza domu czy parametry procesu produkcyjnego mogą zostać przeanalizowane bez opuszczania urządzenia. Nie oznacza to automatycznie pełnej prywatności, ponieważ aplikacja nadal może zapisywać lub przesyłać wyniki. Edge AI daje jednak możliwość ograniczenia transmisji już na poziomie architektury systemu, zamiast polegać wyłącznie na obietnicy usługodawcy.
Procesor CPU musi radzić sobie z bardzo różnymi zadaniami. Wykonuje logikę systemu operacyjnego, obsługuje aplikacje i sprawnie realizuje sekwencyjne instrukcje. GPU powstało z myślą o masowo równoległych obliczeniach graficznych, a jego architektura okazała się również bardzo skuteczna w uczeniu sieci neuronowych.
NPU jest jeszcze bardziej wyspecjalizowane. Jego konstrukcja podporządkowana jest operacjom powtarzającym się w modelach AI, przede wszystkim mnożeniu i sumowaniu dużych zbiorów liczb. Układ zawiera wiele jednostek MAC, pamięć umieszczoną blisko części obliczeniowej oraz mechanizmy sprawnego przetwarzania tensorów i wektorów. NPU rezygnuje więc z części uniwersalności CPU na rzecz lepszego stosunku wydajności do poboru mocy.
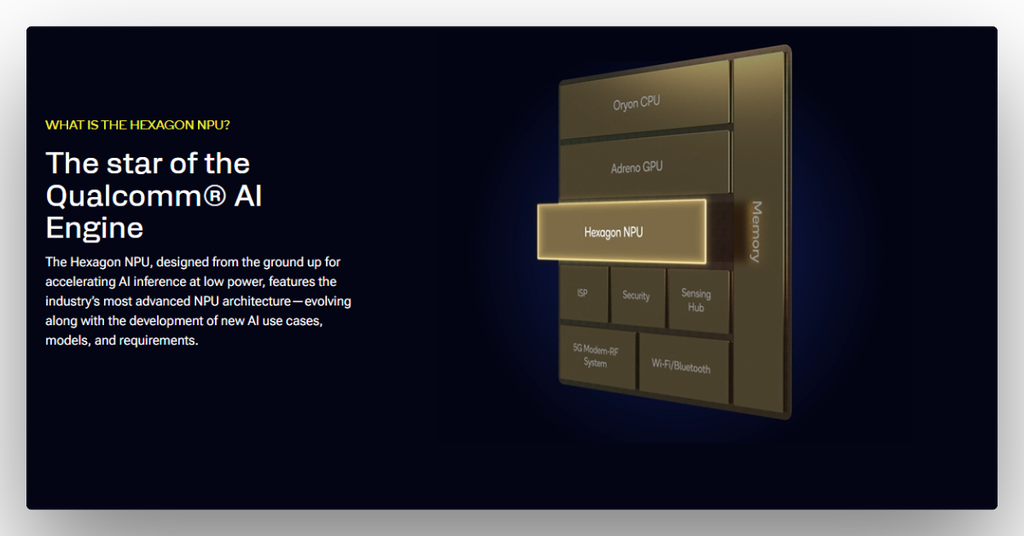
Nie oznacza to, że cały model musi pracować wyłącznie na jednym bloku krzemowym. Nowoczesny system na chipie jest raczej zespołem specjalistów. CPU steruje przebiegiem zadania, GPU przejmuje wybrane operacje równoległe, procesor sygnałowy obrabia dane z mikrofonów lub kamer, a NPU wykonuje najbardziej typowe obliczenia sieci neuronowej. Qualcomm na przykład, opisuje swój Hexagon NPU właśnie jako część architektury heterogenicznej, w której jednostki skalarne, wektorowe i tensorowe współpracują ze wspólną pamięcią.
Największa zmiana zachodzi zatem na poziomie projektu całego systemu, a nie liczby rdzeni. Konstruktorzy muszą zdecydować, gdzie umieścić dane, jak ograniczyć ich kopiowanie i któremu blokowi powierzyć każdą część modelu. O wydajności coraz częściej przesądza koszt przenoszenia informacji między pamięcią a jednostkami obliczeniowymi, a nie sama liczba działań matematycznych. IBM Research wskazuje ten ruch danych jako jedno z podstawowych ograniczeń współczesnych architektur AI.
Producenci chętnie opisują NPU za pomocą TOPS, czyli bilionów operacji na sekundę. Liczba wygląda efektownie i pozornie pozwala łatwo porównać dwa układy. Problem w tym, że wynik zależy między innymi od precyzji obliczeń, rodzaju operacji oraz sposobu traktowania zerowych elementów modelu.
| Format | Co oznacza? | Precyzja | Zużycie pamięci | Szybkość | Typowe zastosowanie |
| FP16 | 16-bitowa liczba zmiennoprzecinkowa | Wysoka | Największe | Niższa | Trenowanie i dokładne uruchamianie modeli AI |
| INT8 | 8-bitowa liczba całkowita | Średnia/wysoka | Około 2× mniejsze niż FP16 | Wyższa | Uruchamianie modeli AI na GPU, CPU i urządzeniach mobilnych |
| INT4 | 4-bitowa liczba całkowita | Niższa | Około 4× mniejsze niż FP16 | Potencjalnie najwyższa | Duże modele językowe na sprzęcie z ograniczoną pamięcią |
Ten sam układ bowiem, może osiągnąć inną wartość dla danych INT4, INT8 i FP16. Wynik może też uwzględniać rzadkość wag, dzięki której część działań jest pomijana. Qualcomm rozróżnia wprost wydajność dla obliczeń gęstych i rzadkich, przy czym wartość dla modelu o odpowiednio uporządkowanej rzadkości może być dwukrotnie wyższa.
Surowa liczba TOPS nie pokazuje również przepustowości pamięci, poboru mocy podczas długiej pracy ani tego, które operacje (warstwy) modelu są rzeczywiście obsługiwane przez NPU. Jeśli fragment sieci musi wrócić na CPU, część teoretycznej przewagi znika. Miarodajny test powinien więc obejmować kompletną aplikację, czas odpowiedzi, energię zużytą na pojedynczą inferencję oraz jakość wyniku.
W prostym przykładzie, można to porównać do oceny samochodu wyłącznie na podstawie mocy silnika. Parametr jest prawdziwy, ale bez informacji o masie, przełożeniach i zużyciu paliwa niewiele mówi o zachowaniu pojazdu na drodze. Z NPU jest podobnie, o wartości układu decyduje cały system, a nie najbardziej atrakcyjna liczba z tabeli.
Największe modele językowe nie mieszczą się swobodnie w pamięci telefonu, a urządzenie nie może przeznaczyć całej baterii na jedną funkcję AI. Dlatego Edge AI rozwija się równolegle z metodami kompresji modeli. Jedną z najważniejszych jest kwantyzacja, czyli zapisywanie wag i wykonywanie części obliczeń z mniejszą precyzją.
Zmiana reprezentacji z 16 lub 32 bitów na 8, 4, a w eksperymentalnych rozwiązaniach nawet mniej, redukuje rozmiar modelu i ilość danych przenoszonych z pamięci. Badania nad metodą AWQ pokazały, że odpowiedni dobór ważniejszych wag (wag, które są najbardziej krytyczne z punktu widzenia aktywacji/błędu kwantyzacji) może czterokrotnie zmniejszyć model, a jednocześnie przyspieszyć jego działanie na urządzeniach brzegowych.
Nie jest to jednak darmowa optymalizacja. Zbyt agresywna kwantyzacja może pogorszyć jakość odpowiedzi, szczególnie w warstwach wrażliwych na utratę precyzji. Dłuższy kontekst zwiększa z kolei rozmiar pamięci podręcznej modelu, więc nawet niewielki asystent może po pewnym czasie natrafić na limit RAM. Do tego dochodzi temperatura. Smartfon potrafi wykonać krótki pokaz AI bardzo szybko, ale przy długiej inferencji musi obniżyć częstotliwość, aby zmieścić się w granicach termicznych.
Edge AI wymusza więc współprojektowanie sprzętu i oprogramowania. Model powinien znać ograniczenia konkretnej architektury, kompilator musi umieć przypisać operacje do właściwych bloków, a system powinien dobierać precyzję do zadania. Najlepszy rezultat nie zawsze daje największy dostępny model. W urządzeniu wykonującym jedną dobrze zdefiniowaną funkcję, mniejsza sieć, wyspecjalizowana i stale dostępna, może być użyteczniejsza od potężnego modelu ogólnego.
W smartfonie lokalny model może podsumować powiadomienia, poprawić zdjęcie, przepisać nagranie albo sklasyfikować treść ekranu. Korzyść jest łatwa do zauważenia, funkcja działa szybciej, bywa dostępna bez sieci i nie musi wysyłać całego materiału do zewnętrznej usługi. Jednocześnie urządzenie ma do dyspozycji kilka lub kilkanaście watów tylko przez krótki czas, a jego pamięć współdzielą wszystkie aplikacje.
W pralce Edge AI może analizować drgania bębna, dźwięk silnika i zmiany poboru prądu. Nie potrzebuje do tego konwersacyjnego modelu z miliardami parametrów. Wystarczy niewielka sieć wykrywająca nietypowy wzorzec, źle rozłożony wsad albo stopniowe zużycie łożyska. Taki algorytm może pracować na mikrokontrolerze z małym NPU, nie generując ciągłego strumienia danych o codziennym funkcjonowaniu domu.
W dronie lokalność staje się warunkiem autonomii. Kamera i czujniki inercyjne dostarczają dane bez przerwy, a system musi na bieżąco oceniać położenie, przeszkody i możliwą trasę. Utrata połączenia nie może oznaczać utraty zdolności widzenia. Chmura może wcześniej pomóc w trenowaniu modelu lub później przeanalizować zapis misji, ale pętla sterowania musi pozostać na pokładzie.
W fabryce urządzenie brzegowe może obserwować drgania maszyny, temperaturę oraz obraz z kamery, a następnie zatrzymać proces po wykryciu niebezpiecznej anomalii. Dane zbiorcze nadal trafią do systemu centralnego, gdzie można porównać wiele linii produkcyjnych i zaktualizować model. Pierwsza reakcja powinna jednak nastąpić lokalnie. W takim układzie Edge AI staje się kolejną warstwą sterowania, wbudowaną bezpośrednio w automatykę.
Urządzenie działające bez internetu może sprawiać wrażenie technologicznie samodzielnego. Chip, który umożliwia tę samodzielność, powstaje jednak dzięki współpracy firm projektujących architekturę, dostawców narzędzi EDA, producentów maszyn litograficznych, fabryk półprzewodników, zakładów pakowania i twórców oprogramowania. Żaden kraj nie kontroluje dziś wszystkich tych etapów na najwyższym poziomie.
Krzemowa niezależność nie powinna zatem oznaczać pełnej autarkii. Bardziej realistycznym celem jest odporność, a więc własne kompetencje projektowe, dostęp do kilku źródeł produkcji, zdolność testowania i pakowania układów, otwarte narzędzia programistyczne oraz zapasy kompetencji, których nie da się odtworzyć w kilka miesięcy.
Europa próbuje budować taką pozycję poprzez European Chips Act. Cel Cyfrowej Dekady zakładał zwiększenie udziału Unii w światowym rynku półprzewodników do 20% do 2030 roku, ale najnowsze dane pokazują, że UE odpowiada obecnie za około 9% rynku. Własne prognozy Komisji wskazywały wcześniej, że bez dodatkowych działań udział ten może sięgnąć jedynie około 12% (11,7%) do 2030 roku. Przedstawiony w czerwcu 2026 roku Chips Act 2.0 kładzie więc większy nacisk na konkretne zdolności projektowe, produkcyjne i odporność łańcucha dostaw niż na sam wskaźnik udziału rynkowego. Aczkolwiek jego podwojenie do 20% nadal jest celem UE.
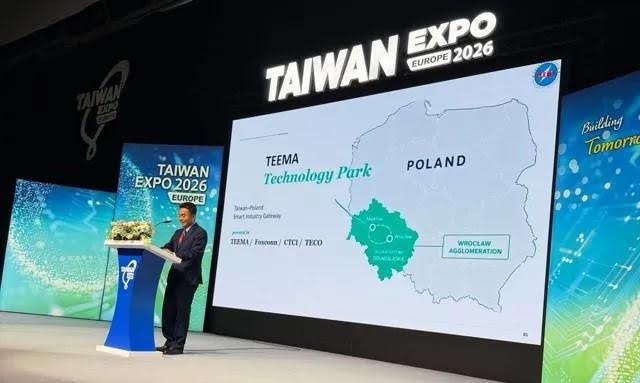
W tym wyścigu liczą się nie tylko najnowocześniejsze fabryki. Uczelnie techniczne mogą rozwijać architektury energooszczędnych akceleratorów, kompilatory, algorytmy kwantyzacji, systemy wbudowane, fotonikę i metody bezpiecznego wdrażania modeli. To szczególnie ważne dla państw, które nie zbudują od razu fabryki najbardziej zaawansowanych procesorów, ale mogą stać się niezbędne w wybranym fragmencie łańcucha wartości. W Polsce fabrykę AI w Miękini wybuduje tajwański Foxconn, ale w bliżej nieokreślonym jeszcze terminie.
Czy Edge AI wygra z chmurą? Trudno to tak jednoznacznie określać, ponieważ nie jest to pojedynek dwóch wzajemnie wykluczających się modeli. Lokalny układ najlepiej radzi sobie z zadaniami powtarzalnymi, wrażliwymi na opóźnienie i prywatność. Chmura zachowuje przewagę wtedy, gdy potrzebny jest największy model, długi kontekst, dostęp do rozległych baz wiedzy lub wspólna analiza danych z wielu urządzeń.
Najbardziej użyteczne systemy będą zatem dynamicznie dzielić pracę. Telefon może lokalnie rozpoznać intencję i usunąć dane wrażliwe, a dopiero później przekazać trudniejsze zadanie do serwera. Maszyna przemysłowa zareaguje na anomalię samodzielnie, lecz wykorzysta chmurę do uczenia na historii całej floty urządzeń. Domowy sprzęt wykona prostą klasyfikację na mikrokontrolerze, ale pobierze nową wersję modelu po przejściu testów bezpieczeństwa.
Prawdziwą miarą postępu nie będzie więc liczba urządzeń z naklejką “AI”. Ważniejsze okaże się to, czy potrafimy świadomie zdecydować, które dane i obliczenia powinny pozostać na brzegu sieci, a które warto przekazać dalej. Bitwa o Edge AI jest w istocie bitwą o architekturę cyfrowego świata, a więc o energię, czas reakcji, prywatność oraz kontrolę nad technologią, która coraz częściej podejmuje decyzje obok nas.