Black & White – premiera książki Brody’ego Neuenschwandera

Robot przemysłowy przez dekady kojarzył się nam z maszyną niezwykle precyzyjną, ale mało elastyczną. Potrafił bezbłędnie powtarzać zaprogramowaną sekwencję, dopóki każdy przedmiot znajdował się w przewidzianym miejscu, a otoczenie nie odbiegało od założeń projektanta. Zmiana produktu, układu stanowiska lub sposobu realizacji zadania oznaczała zwykle przeprogramowanie systemu, ponowną konfigurację i testy.
Modele Vision-Language-Action, w skrócie VLA, proponują inne podejście. Łączą analizę obrazu, rozumienie języka i sterowanie ruchem, dzięki czemu robot może otrzymać opis celu zamiast kompletnej listy instrukcji. Dla przykładu może być to polecenie “ułóż elementy od najmniejszego do największego”, które zawiera wprawdzie intencję, lecz nie określa współrzędnych, kolejności chwytów ani trajektorii ramienia. System VLA ma sam rozpoznać obiekty, ustalić relacje między nimi i przełożyć wynik rozumowania na działanie fizyczne.
Nie oznacza to oczywiście jeszcze narodzin w pełni uniwersalnej maszyny, którą można postawić w dowolnym magazynie i od razu powierzyć jej każde zadanie. VLA jest jednak istotnym krokiem od automatyzacji opartej na sztywnych procedurach do robotyki, która reaguje na znaczenie polecenia i sytuację obserwowaną przez kamery.
Najprościej rzecz ujmując, model VLA możemy rozłożyć na trzy czynniki składające się z jego nazwy, a realizujące powiązane ze sobą funkcje:
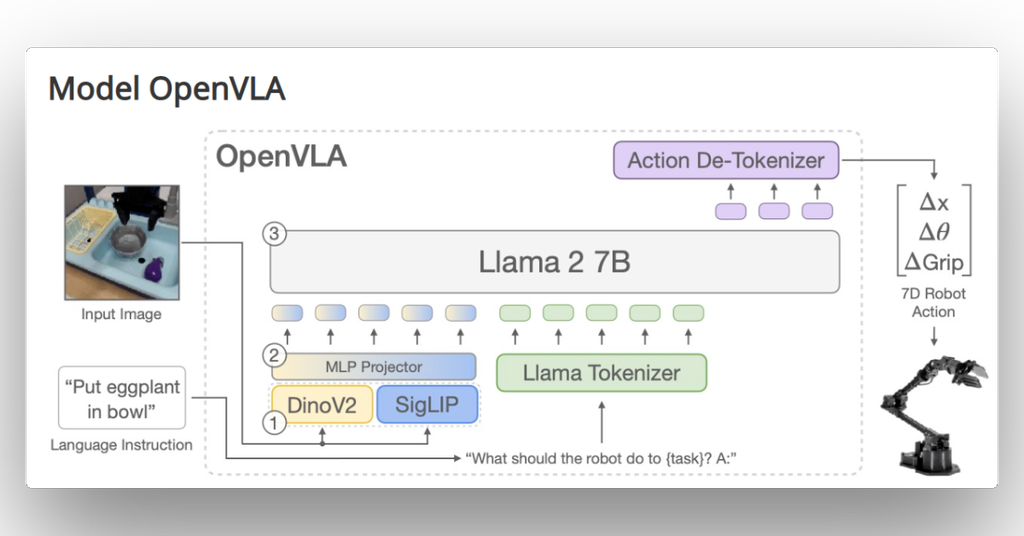
W klasycznym systemie te etapy bywają realizowane przez odrębne moduły, między którymi inżynierowie projektują reguły wymiany informacji. Model VLA dąży natomiast do nauczenia wspólnego odwzorowania, od obrazu i polecenia do ruchu. W pracy opisującej RT-2 działania robota zapisano w postaci tokenów, czyli symboli przetwarzanych podobnie jak fragmenty tekstu. Model był następnie wspólnie dostrajany na danych internetowych łączących język z obrazem oraz na trajektoriach robotów.
To właśnie połączenie wiedzy wizualno-językowej z doświadczeniem ruchowym stanowi o potencjale VLA. Robot nie musi znać wyłącznie obiektów występujących w jednym, dokładnie opisanym procesie. Może wykorzystać szersze pojęcia, takie jak rozmiar, kolor, przeznaczenie czy podobieństwo, a następnie odnieść je do aktualnej sceny.
Polecenie głosowe wymaga przy tym dodatkowego wyjaśnienia. Typowy model VLA przyjmuje instrukcję tekstową, więc wypowiedź pracownika jest najpierw zamieniana na tekst przez system rozpoznawania mowy. Powstają już rozwiązania przetwarzające sygnał audio bardziej bezpośrednio, lecz nie jest to jeszcze cecha każdego modelu określanego jako VLA.
Wyobraźmy sobie stanowisko, przy którym znajdują się pojemniki z różnymi częściami. Operator prosi robota, aby odłożył uszkodzone elementy do kontroli, a pozostałe uporządkował według wielkości. Dla człowieka to zrozumiałe zadanie. Dla tradycyjnego automatu każde pojęcie należałoby wcześniej opisać za pomocą reguł, klas obiektów i możliwych stanów procesu.
System VLA analizuje obraz z kamer, wiąże słowa z widocznymi przedmiotami i generuje kolejne fragmenty ruchu. Nie musi od razu planować całej operacji. Może pracować w pętli, a więc wykonać część ruchu, ponownie ocenić scenę, skorygować trajektorię i przejść do następnego kroku. Taki zamknięty obieg percepcji i działania jest potrzebny, ponieważ obiekt może się przesunąć, chwyt może okazać się niedokładny, a w polu pracy może pojawić się człowiek.
Istotną rolę odgrywa uczenie na wielu zbiorach danych i typach robotów. OpenVLA, jeden z najważniejszych otwartych projektów w tej dziedzinie, ma 7 miliardów parametrów i został wytrenowany na 970 tysiącach epizodów robotycznych ze zbioru Open X-Embodiment. Model ten może obsługiwać różne konstrukcje, a do nowego stanowiska da się go przystosować metodami dostrajającymi jedynie część parametrów.
Otwarty kod, gotowe wagi modeli i symulatory obniżają barierę wejścia dla laboratoriów oraz zespołów badawczo-rozwojowych. Nie usuwają jednak potrzeby gromadzenia demonstracji z konkretnej maszyny. Ten sam cel musi zostać wyrażony innymi ruchami przez niewielkie ramię stołowe, robota mobilnego i konstrukcję humanoidalną.
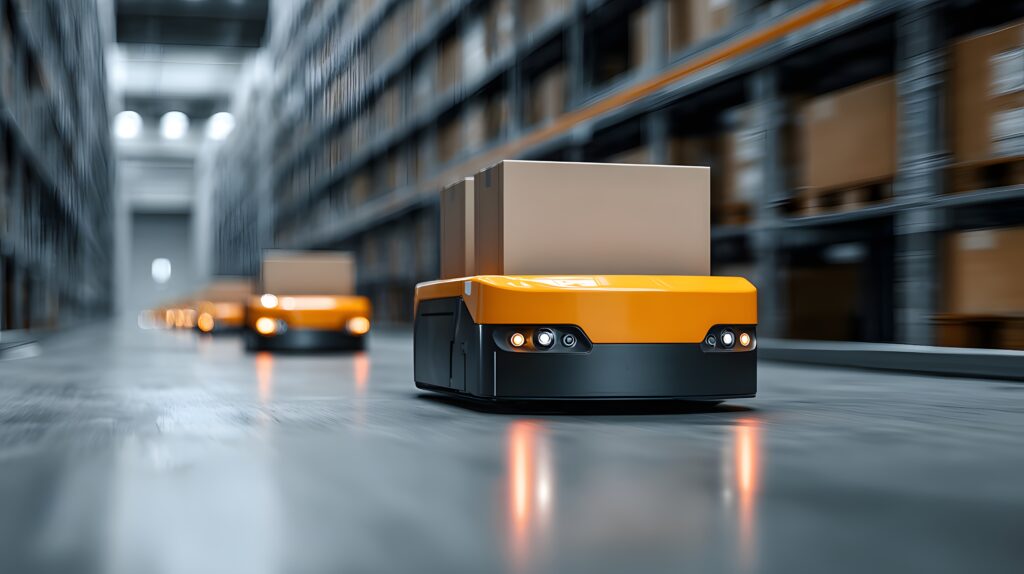
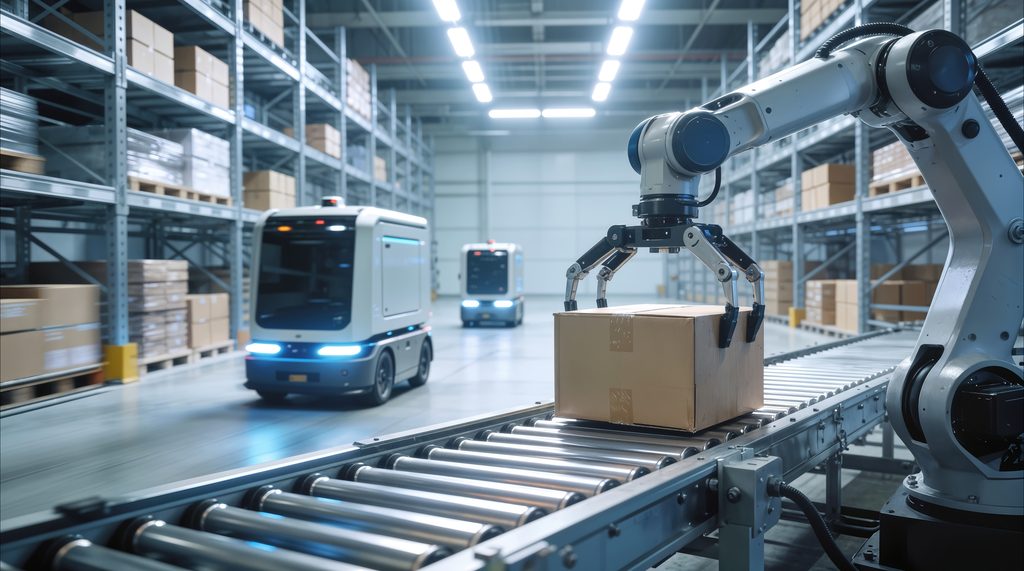
Magazyn łączy dużą liczbę powtarzalnych operacji z ciągłą zmiennością. Towary różnią się kształtem, opakowaniem i położeniem, zamówienia tworzą odmienne sekwencje, a układ stref może zmieniać się wraz z sezonem. Klasyczna automatyzacja działa najlepiej tam, gdzie tę zmienność można ograniczyć. VLA ma pomóc maszynom radzić sobie także wtedy, gdy nie da się opisać każdej sytuacji z wyprzedzeniem.
Potencjalne zastosowania obejmują więc:
Skala potrzeb jest duża. Według Międzynarodowej Federacji Robotyki sprzedaż profesjonalnych robotów usługowych przeznaczonych do transportu towarów i ładunków wzrosła o 44% między 2021 a 2022 rokiem. Organizacja wskazuje jednocześnie na niedobór pracowników w logistyce oraz rosnące wykorzystanie systemów wizyjnych i autonomicznych platform transportowych.
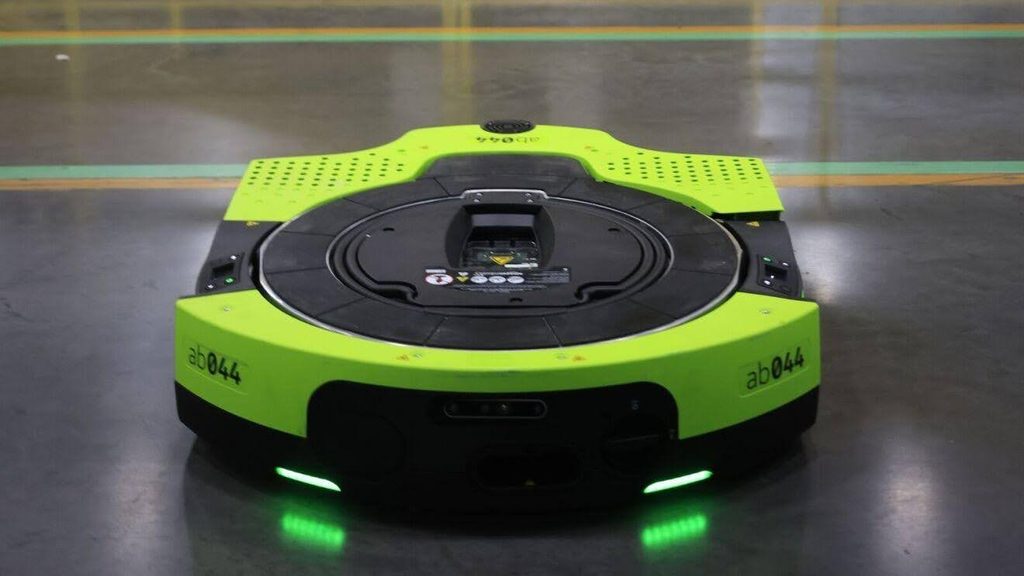
Kierunek rozwoju widać również w rozwiązaniach projektowanych przez największych operatorów. Amazon zapowiedział nową wersję mobilnego robota Proteus, której zadania można przekazywać potocznym językiem. System ma docelowo transportować kontenery i ciężkie wózki między różnymi strefami obiektu. Producent nie określa go wprawdzie wprost jako modelu VLA, ale można potraktować to jako dowód szerszego trendu w kierunku językowych interfejsów robotów.
Tradycyjna linia automatyczna bywa kosztowna nie tylko ze względu na sprzęt. Znaczną część inwestycji pochłania integracja, programowanie wariantów procesu i późniejsze modyfikacje. Jeżeli system VLA można dostroić za pomocą demonstracji oraz poleceń, czas potrzebny na wdrożenie kolejnego zadania może się skrócić. W przedsiębiorstwie obsługującym zmienny asortyment ma to większe znaczenie niż rekordowa szybkość jednego, niezmiennego ruchu.
Demokratyzacji sprzyjają trzy zjawiska. Pierwszym jest rozwój otwartych modeli, takich jak wspomniany wyżej OpenVLA. Drugim są środowiska symulacyjne, w których można generować dane i sprawdzać zachowanie robota bez zatrzymywania hali. Trzecim są techniki dostrajania wymagające modyfikacji niewielkiej części modelu, co ogranicza zapotrzebowanie na zasoby obliczeniowe w porównaniu z treningiem od podstaw.
Dobrym przykładem kompletnego ekosystemu jest platforma NVIDIA Isaac GR00T. Łączy ona bowiem modele bazowe dla robotów, narzędzia do tworzenia danych, symulację oraz rozwiązania do uruchamiania modeli na komputerze pokładowym. Producent zaznacza jednak, że część udostępnianych wersji ma charakter badawczy i prototypowy, a dostosowanie do nowego sprzętu nadal wymaga demonstracji konkretnego zadania.
Dla średniej firmy najbardziej realistyczną drogą nie jest zatem zakup “robota do wszystkiego”. Bardziej prawdopodobne jest wdrożenie gotowej platformy sprzętowej z modelem bazowym, a następnie dostrojenie jej do kilku procesów o wysokim koszcie pracy lub dużej zmienności. Opłacalność zależy od stabilności modelu, częstotliwości zmian asortymentu, kosztów integracji czy dostępności danych oraz możliwości bezpiecznego odseparowania obszaru pracy.
Model językowy może wygenerować błędną odpowiedź bez fizycznych konsekwencji. Błąd robota może natomiast uszkodzić towar, maszynę albo zagrozić człowiekowi. Dlatego VLA nie powinien samodzielnie zastępować deterministycznych układów bezpieczeństwa. Ograniczenia prędkości i siły, awaryjne zatrzymanie, kontrola stref, wykrywanie kolizji oraz weryfikacja dozwolonych ruchów muszą działać niezależnie od decyzji modelu.
Problemem pozostaje także odporność na zmianę warunków. W badaniu obejmującym siedem modeli i cztery zadania manipulacyjne niewielkie modyfikacje położenia kamery obniżyły średnio liczbę zaliczonych wcześniej prób do 34% wyniku bazowego. Zmiana oświetlenia również pogarszała skuteczność, a nieznane obiekty utrudniały przede wszystkim prawidłową lokalizację celu.
To oczywiście nie wszystkie wyzwania, bo trzeba wziąć również pod uwagę takie aspekty jak:
Natomiast szczególnej uwagi wymaga wejście wizyjne. Badacze pokazali, że odpowiednio przygotowany wzór umieszczony w polu kamery może zaburzyć trajektorię modelu VLA, także podczas testów na fizycznym robocie. Wyniki te nie dowodzą, że każdy system można łatwo zaatakować w identyczny sposób, ale potwierdzają potrzebę niezależnego monitorowania ruchu i testów odporności przed wdrożeniem.
Rozsądny projekt pilotażowy powinien zaczynać się od wąskiego, mierzalnego procesu. Zamiast polecenia “obsłuż strefę przyjęć” lepiej wybrać zadanie polegające na sortowaniu kilku kategorii opakowań albo przenoszeniu pojemników między zdefiniowanymi punktami. Zakres działania pozostaje ograniczony, lecz sposób wykonania może być bardziej elastyczny niż w tradycyjnym programie.
Kolejne etapy obejmują zebranie demonstracji, trening lub dostrojenie modelu, testy w symulacji, próby na wydzielonym stanowisku oraz stopniowe poszerzanie zakresu. Mierzyć należy nie tylko odsetek ukończonych zadań. Ważne są także liczba interwencji człowieka, czas cyklu, błędy chwytu, przypadki naruszenia strefy bezpieczeństwa czy odporność na zmianę światła i zachowanie przy poleceniach niejednoznacznych.
System powinien również potrafić odmówić działania. Jeśli kamera nie widzi całej sceny, polecenie jest sprzeczne albo obiekt znajduje się poza bezpiecznym zasięgiem, poprawną reakcją nie jest zgadywanie. Robot powinien zatrzymać się, zgłosić problem i poprosić operatora o doprecyzowanie.
Dotychczas człowiek opisywał przede wszystkim procedurę, czyli współrzędne, kolejność ruchów i reakcje na konkretne sygnały. W podejściu VLA może w większym stopniu opisać rezultat, a część planowania pozostawić maszynie.
To przesuwa kompetencje potrzebne w zakładzie. Nadal niezbędni będą specjaliści od automatyki, mechaniki i bezpieczeństwa, ale wzrośnie znaczenie inżynierii danych, symulacji, testowania modeli oraz projektowania interakcji człowiek-robot. Osoby, które chcą pogłębić wiedzę z zakresu sztucznej inteligencji, computer vision, programowania robotów i systemów autonomicznych, mogą rozważyć studia podyplomowe na naszej uczelni na kierunku Autonomiczna robotyka.
VLA nie eliminuje programowania robotów, lecz przenosi jego część na poziom uczenia z danych i definiowania ograniczeń. Maszyna otrzymuje więcej swobody w doborze działania, dlatego system otaczający model musi jeszcze dokładniej określać granice tej swobody. Jeśli uda się pogodzić elastyczność z powtarzalnością i bezpieczeństwem, roboty rozumiejące cel zadania mogą stać się jednym z najważniejszych narzędzi kolejnego etapu automatyzacji magazynów, logistyki i produkcji.